Big data
Содержание:
- Кто и как собирает данные?
- Проблемы с Big-Data
- Немного истории
- Монетизация знаний о клиентах: персонализация маркетинга
- Перспективы и тенденции развития Big data
- Структура специализации
- Лучшие книги по Big Data
- Что такое Big data?
- Примеры использования Big Data
- «Микрон»: оптимизация производства и повышение качества продукции
- Перспективы развития
- MapReduce
- Kubeflow: MLOps в Kubernetes
- Проблемы Big Data
- VVV — признаки больших данных
- Большие данные: с чего начать
- Советы
Кто и как собирает данные?
Всю работу можно условно разделить на три этапа: интеграция, управление и анализ.
Этап 1. Интеграция
На первом этапе компания должна определить цели внедрения Big Data, выбрать инструменты сбора информации, а также связать их со своими источниками поступающих данных.
Этап 2. Управление
На этом этапе выбирается платформа для хранения информации. Компании могут использовать локальные хранилища, публичные или частные облачные сервисы.
Этап 3. Аналитика
Большие данные должны работать на бизнес, однако они начинают приносить пользу после анализа. Это заключительный этап взаимодействия с ними.
Проблемы с Big-Data
Биг Дата дает нам беспрецедентные идеи и возможности, но также поднимает проблемы и вопросы, которые необходимо решить:
- Конфиденциальность данных – Big-Data, которую мы сегодня генерируем, содержит много информации о нашей личной жизни, на конфиденциальность которой мы имеем полное право. Все чаще и чаще нас просят найти баланс между количеством персональных данных, которые мы раскрываем, и удобством, которое предлагают приложения и услуги, основанные на использовании Биг Даты.
- Защита данных — даже если мы решаем, что нас устраивает то, что у кого-то есть наши данные для определенной цели, можем ли мы доверять ему сохранность и безопасность наших данных?
- Дискриминация данных — когда вся информация будет известна, станет ли приемлемой дискриминация людей на основе данных из их личной жизни? Мы уже используем оценки кредитоспособности, чтобы решить, кто может брать деньги, и страхование тоже в значительной степени зависит от данных. Нам стоит ожидать, что нас будут анализировать и оценивать более подробно, однако следует позаботиться о том, чтобы это не усложняло жизнь тех людей, которые располагают меньшими ресурсами и ограниченным доступом к информации.
Выполнение этих задач является важной составляющей Биг Даты, и их необходимо решать организациям, которые хотят использовать такие данные. Неспособность осуществить это может сделать бизнес уязвимым, причем не только с точки зрения его репутации, но также с юридической и финансовой стороны
Немного истории
Определение Биг Data – это только «верхушка айсберга». Разбираться с соответствующим понятием на самом деле весьма трудно. Особенно если не понимать, как проводить дальнейший анализ материалов.
Первые упоминания Биг Data появились в 60-70-х годах прошлого века. Тогда начался активный рост и развитие информационных технологий. И продолжается подобный прогресс по сей день. Это не может не отражаться на «дате» — то, что еще 10 лет назад казалось огромным объемом, теперь является «мелочью». Чтобы убедиться в этом, достаточно посмотреть на размеры памяти современных девайсов или «вес» выпускаемого софта.
С 2005 года организации начали потихоньку разбираться в масштабах софта пользовательских интернет сервисов – YouTube, OK, VK и так далее. Тогда же появилась одна из первых платформ для работы с большими объемами данных. Она получила названием Hadoop. Сегодня так называют суперкомпьютер, стек, предназначенный для Big Дата. Чуть позже мир узнал об еще одной технологии – NoSQL, которая представлена связью методов, которыми создаются системы управления Big Data.
Монетизация знаний о клиентах: персонализация маркетинга
Здесь мы уже рассказывали о том, что потребитель не хочет быть безликой единицей вашей целевой аудитории – клиенту нужны и важны рекламные предложения только по той продукции, которая интересна именно ему . Даже для одного товара/услуги можно создать десятки версий одного контента, который даст надежный отклик в узком сегменте покупателей. Например, один клиент в автомобилях наиболее ценит их экономичность и экологичность, другой – безопасность и вместительность машины, а третий – эффектный внешний вид и скоростные характеристики .
Помимо снижения коэффициента оттока (Churn Rate), стимуляции повторных обращений, дополнительных продаж и создания превентивного спроса у существующих клиентов, аналитические инструменты Big Data помогут вам привлечь новых пользователей. А также превратить посетителей в покупателей за счет персонализированного маркетинга и оперативной генерации индивидуальных рекламных предложений, привлекательных именно для этого клиента . Как сократить рекламный бюджет, увеличив итоговую выручку компании, читайте здесь.

Персонализированный маркетинг – повысит доход от текущих клиентов и привлечет новых покупателей
Перспективы и тенденции развития Big data
В 2017 году, когда большие данные перестали быть чем-то новым и неизведанным, их важность не только не уменьшилась, а еще более возросла. Теперь эксперты делают ставки на то, что анализ больших объемов данных станет доступным не только для организаций-гигантов, но и для представителей малого и среднего бизнеса
Такой подход планируется реализовать с помощью следующих составляющих:
Облачные хранилища
Хранение и обработка данных становятся более быстрыми и экономичными – по сравнению с расходами на содержание собственного дата-центра и возможное расширение персонала аренда облака представляется гораздо более дешевой альтернативой.
Использование Dark Data
Так называемые «темные данные» – вся неоцифрованная информация о компании, которая не играет ключевой роли при непосредственном ее использовании, но может послужить причиной для перехода на новый формат хранения сведений.
Искусственный интеллект и Deep Learning
Технология обучения машинного интеллекта, подражающая структуре и работе человеческого мозга, как нельзя лучше подходит для обработки большого объема постоянно меняющейся информации. В этом случае машина сделает все то же самое, что должен был бы сделать человек, но при этом вероятность ошибки значительно снижается.
Blockchain
Эта технология позволяет ускорить и упростить многочисленные интернет-транзакции, в том числе международные. Еще один плюс Блокчейна в том, что благодаря ему снижаются затраты на проведение транзакций.
Самообслуживание и снижение цен
В 2017 году планируется внедрить «платформы самообслуживания» – это бесплатные площадки, где представители малого и среднего бизнеса смогут самостоятельно оценить хранящиеся у них данные и систематизировать их.
Структура специализации
В 2020 году аналитика Big Data используется в более чем 55% компаний по всему миру. При этом рост объемов рынка решений в Центральной и Восточной Европе ежегодно увеличивается на 11%, и в 2022 году составит 5,4 млрд. долл.
Есть две основные специализации Big Data:
- Инженеры – отвечают за хранение, преобразование информации и быстрый доступ к ней.
- Аналитики – отвечают за анализ большого количества информации, выявление взаимосвязей и построение моделей.
Чтобы стать профессионалом своего дела, в целом требуется овладеть следующими знаниями:
Программирование
Важно знать как минимум два языка программирования (чем больше, тем лучше), поскольку кодирование является основой для проведения численного и статистического анализа больших массивов данных. Наиболее популярны R, Python, Ruby, C++, Java, Scala и Julia.
Количественные способности
Необходимо обладать твердыми знаниями статистики и математики, включая линейную алгебру, многомерное исчисление, распределение вероятностей, проверку гипотез, байесовский анализ, анализ временных рядов и продольный анализ.
Вычислительные инструменты. Работа аналитика Big Data универсальна. Пользователь должен чувствовать себя комфортно при работе с различными инструментами и вычислительными фреймворками, включая базовые (Excel и SQL) и продвинутые (Hadoop, MapReduce, Spark, Storm, SPSS, Cognos, SAS и MATLAB). Эти технологии помогают в обработке больших данных, которые можно передавать в потоковом режиме.
Хранение данных. Каждый аналитик должен обладать навыками работы с реляционными и нереляционными системами БД, такими как MySQL, Oracle, DB2, NoSQL, HDFS, MongoDB, CouchDB, Cassandra.
Деловая хватка. Какой толк в выводах аналитиков, если они не могут визуализировать их с точки зрения бизнеса? Чтобы использовать полученные знания на практике, нужно иметь понимание делового мира. Только тогда можно определить потенциальные возможности для бизнеса и использовать полученные результаты для принятия наиболее эффективных решений.
Коммуникативные навыки. Необходимо знать, как эффективно передавать и представлять свои выводы для облегчения понимания другими специалистами – то есть обладать безупречными навыками письменной и устной коммуникации, чтобы объяснить свое видение другим и разложить сложные идеи на более простые термины.
Знание английского языка на уровне чтения технической документации.
Навык машинного обучения.
Также очень важно основательно знать отрасль, в которой происходит работа. Постоянно обучаясь и развиваясь, специалист по Big Data может пройти следующий карьерный путь:
Постоянно обучаясь и развиваясь, специалист по Big Data может пройти следующий карьерный путь:
- Стажер.
- Младший аналитик.
- Аналитик.
- Старший аналитик.
- Руководитель отдела.
- Директор управления по анализу.
Лучшие книги по Big Data
«The Human Face of Big Data», Рик Смолан и Дженнифер Эрвитт
Подойдет для первоначального изучения технологий обработки больших данных – легко и понятно вводит в курс дела. Дает понять, как обилие информации повлияло на повседневную жизнь и все ее сферы: науку, бизнес, медицину и т. д. Содержит многочисленные иллюстрации, поэтому воспринимается без особых усилий.
«Introduction to Data Mining», Панг-Нинг Тан, Майкл Стейнбах и Випин Кумар
Также полезная для новичков книга по Big Data, объясняющая работу с большими данными по принципу «от простого к сложному». Освещает многие немаловажные на начальном этапе моменты: подготовку к обработке, визуализацию, OLAP, а также некоторые методы анализа и классификации данных.
«Python Machine Learning», Себастьян Рашка
Практическое руководство по использованию больших данных и работе с ними с применением языка программирования Python. Подходит как студентам инженерных специальностей, так и специалистам, которые хотят углубить свои знания.
«Hadoop for Dummies», Дирк Дерус, Пол С. Зикопулос, Роман Б. Мельник
Hadoop – это проект, созданный специально для работы с распределенными программами, организующими выполнение действий на тысячах узлов одновременно. Знакомство с ним поможет более детально разобраться в практическом применении больших данных.
Что такое Big data?
Большие данные — технология обработки информации, которая превосходит сотни терабайт и со временем растет в геометрической прогрессии.
Такие данные настолько велики и сложны, что ни один из традиционных инструментов управления данными не может их хранить или эффективно обрабатывать. Проанализировать этот объем человек не способен. Для этого разработаны специальные алгоритмы, которые после анализа больших данных дают человеку понятные результаты.
В Big Data входят петабайты (1024 терабайта) или эксабайты (1024 петабайта) информации, из которых состоят миллиарды или триллионы записей миллионов людей и все из разных источников (Интернет, продажи, контакт-центр, социальные сети, мобильные устройства). Как правило, информация слабо структурирована и часто неполная и недоступная.
Примеры использования Big Data
- создания контента для разной целевой аудитории;
- разработки персональных рекомендаций;
- измерения эффективности контента.
Например, музыкальный сервис Spotify использует big data для сбора данных от миллионов пользователей по всему миру, а затем использует проанализированные данные для предоставления музыкальных рекомендаций отдельным пользователям.
Рекламодатели – одни из крупнейших игроков в сфере больших данных. Facebook, Google, Яндекс или любой другой онлайн-гигант – все они отслеживают поведение пользователей. В результате они предоставляют рекламодателям большой объем данных для точной настройки кампаний. Возьмем, к примеру, Facebook. Здесь можно выбрать аудиторию на основе покупательского намерения, посещений веб-сайтов, интересов, должности, демографии и т.д. Все эти данные собираются алгоритмами Facebook с использованием методов анализа big data.
Логистика
Логистические компании уже довольно давно используют аналитику для отслеживания заказов и составления отчетов. Благодаря большим данным можно отслеживать состояние товаров в пути и оценивать потери. В режиме реального времени собираются данные о дорожном движении, погодных условиях и определяются маршруты для транспортировки грузов. Это помогает логистическим компаниям снизить риски, повысить скорость и надежность доставки.
Медицина
Большие данные в здравоохранении используются для улучшения качества жизни, лечения болезней, сокращения непроизводительных затрат, прогнозирования эпидемий. Используя big data, больницы могут повысить уровень обслуживания пациентов.
Розничная и оптовая торговля
Взаимодействие с поставщиками, покупателями, анализ запасов на складе, прогнозирование продаж – это лишь часть функций, с которыми помогает справляться Big Data.
Государственные структуры
В качестве примеров: учет налоговых поступлений, сбор и анализ данных, собранных в интернете (новости, социальные сети, форумы и т.д.) для противодействия экстремизму и организованной преступности, оптимизация транспортной сети, выявление районов избыточной концентрации работающего, проживающего или незанятого населения, изучение предпосылок к развитию территорий и так далее.
Банковская сфера
Сбор и анализ информации помогает банкам бороться с мошенничеством, эффективно работать с клиентами (сегментировать, проводить оценку кредитоспособности клиентов, предлагать новые продукты), управлять работой отделений (например, прогнозировать очереди, нагрузку специалистов и так далее).
Предупреждение природных и техногенных катастроф
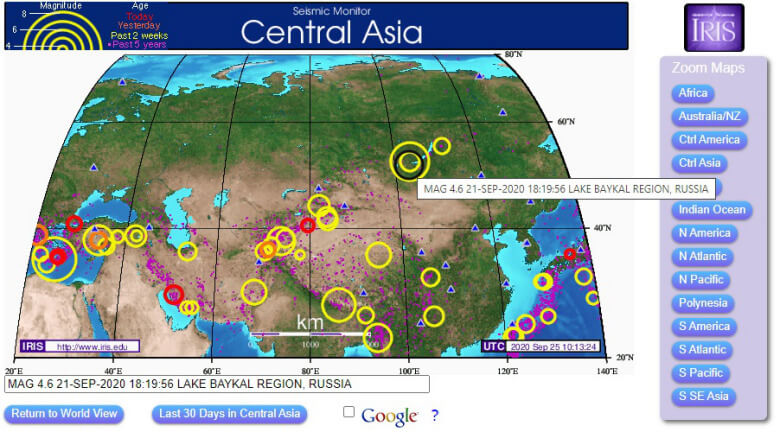
Множество машин ежедневно отслеживают сейсмическую активность в режиме реального времени. Это позволяет ученым спрогнозировать землетрясение. Даже обычным пользователям интернета также доступны эти инструменты наблюдений: есть различные, на которых представлены интерактивные карты.
Для сохранения безопасности на предприятиях также внедряются технологии, позволяющие обнаруживать и прогнозировать риски и предотвращать несчастные случаи.
«Микрон»: оптимизация производства и повышение качества продукции
Российский производитель микроэлектроники повысил эффективность калибровочных запусков на своём заводе благодаря big data. Решение, которое разработали в МТС, позволило предприятию на треть снизить время, необходимое для настройки оборудования. Контроль за этим этапом работы очень важен — от него зависит частота сбоев и качество итоговой продукции. Технологический процесс на «Микроне» высокоавтоматизирован и включает сотни однотипных операций, которые генерируют большие массивы данных. Теперь при каждом сбое не приходится заново калибровать всю систему, так как на основе собранных ранее данных можно с высокой точностью определить, какой компонент сработал некорректно.
Внедрение технологичных решений на предприятиях и анализ большого массива данных помогает оптимизировать затраты, работать эффективнее и повышать конкурентоспособность. А вопрос хранения информации удобнее всего решать при помощи облачных технологий.
Перейти в облако
Перспективы развития
Для простого анализа Big Data не так необходимы. Но у всех возникает вопрос о том, насколько соответствующая область в ближайшие десятилетия будет востребована. Сейчас она «на высоте», а что будет через 5-10 лет, неизвестно.
Blockchain и Big Data – перспективные и дополняющие друг друга области. Примерно с 2015-2016 года активно появляются в СМИ и набирают обороты. Криптографически безопасные технологии способны обеспечить надежную защиту сведений, сохраняя ее конфиденциальность. Для того, чтобы решить проблемы Big Data, используется Блокчейн.
Также стоит отметить, что почти все отрасли деятельности людей занимаются инвестициями в большие данные. Аналитика рассматриваемых «материалов» поможет отслеживать транзакции и обнаруживать скрытые схемы (при подключении Блокчейна). Все это – весьма перспективно и актуально. А с учетом того, что современный мир активно развивает IT-технологии, Big Data и их ценность с течением времени будет только увеличиваться.
MapReduce

MapReduce предполагает, что данные организованы в виде некоторых записей. Обработка данных происходит в 3 стадии:
1. Стадия Map. На этой стадии данные предобрабатываются при помощи функции map(), которую определяет пользователь. Работа этой стадии заключается в предобработке и фильтрации данных. Работа очень похожа на операцию map в функциональных языках программирования – пользовательская функция применяется к каждой входной записи. Функция map() примененная к одной входной записи и выдаёт множество пар ключ-значение. Множество – т.е. может выдать только одну запись, может не выдать ничего, а может выдать несколько пар ключ-значение. Что будет находится в ключе и в значении – решать пользователю, но ключ – очень важная вещь, так как данные с одним ключом в будущем попадут в один экземпляр функции reduce.
2. Стадия Shuffle. Проходит незаметно для пользователя. В этой стадии вывод функции map «разбирается по корзинам» – каждая корзина соответствует одному ключу вывода стадии map. В дальнейшем эти корзины послужат входом для reduce.
3. Стадия Reduce. Каждая «корзина» со значениями, сформированная на стадии shuffle, попадает на вход функции reduce(). Функция reduce задаётся пользователем и вычисляет финальный результат для отдельной «корзины». Множество всех значений, возвращённых функцией reduce(), является финальным результатом MapReduce-задачи.
Несколько дополнительных фактов про MapReduce:
1) Все запуски функции map работают независимо и могут работать параллельно, в том числе на разных машинах кластера.
2) Все запуски функции reduce работают независимо и могут работать параллельно, в том числе на разных машинах кластера.
3) Shuffle внутри себя представляет параллельную сортировку, поэтому также может работать на разных машинах кластера. Пункты 1-3 позволяют выполнить принцип горизонтальной масштабируемости.
4) Функция map, как правило, применяется на той же машине, на которой хранятся данные – это позволяет снизить передачу данных по сети (принцип локальности данных).
5) MapReduce – это всегда полное сканирование данных, никаких индексов нет. Это означает, что MapReduce плохо применим, когда ответ требуется очень быстро.
Kubeflow: MLOps в Kubernetes
Модели машинного обучения важно быстро разворачивать в продакшене, иначе данные устареют и появятся проблемы воспроизводимости экспериментов. Но иногда процесс построен так, что передача моделей от Data Scientist к Data Engineer занимает много времени
Справиться с этой проблемой помогает MLOps. Это подход, который стандартизирует процесс разработки моделей машинного обучения и сокращает время их выкатки в продакшен. С его помощью новые модели быстро передаются в производство и начинают приносить пользу бизнесу. Но чтобы применять этот подход, нужны специальные инструменты.
Один из таких инструментов — Kubeflow, это платформа для машинного обучения и Data Science. В состав Kubeflow входит JupyterHub, поэтому его можно не разворачивать отдельно. Также он помогает решать проблемы трекинга экспериментов, моделей и артефактов. Плюс Kubeflow позволяет выводить модели в продакшен за несколько минут и делать их доступными в виде сервиса.
Преимущества запуска Kubeflow в Kubernetes: Kubeflow специально создавался для Kubernetes, поэтому отдельно его в принципе нельзя запустить. Здесь, скорее, стоит упомянуть о преимуществах Kubeflow перед другими не-Kubernetes аналогами: быстрая публикация моделей, оркестрация сложных пайплайнов, удобный UI для управления экспериментами и мониторингом моделей.
Как запустить Kubeflow в Kubernetes: есть подробная инструкция на официальном сайте. Либо можно упростить себе жизнь, развернув Kubeflow в облачном Kubernetes по этому руководству.
Но стоит учесть, что Kubeflow еще развивается, поэтому он немного сыроват. Есть альтернатива — MLflow, более стабильная платформа, но она работает с Kubernetes только . Если сравнивать между собой Kubeflow и MLflow, то первый лучше масштабируется, более функциональный и перспективный. MLflow же проще в использовании и более зрелый как продукт, поэтому подходит для промышленного использования, хотя и не обладает такой широтой функциональности, как Kubeflow (к примеру, в MLflow не встроен JupyterHub).
Полезные ссылки:
- Сравнение Kubeflow и MLflow.
- Kubeflow overview.
- MLflow Quickstart.
- MLflow в Kubernetes.
Проблемы Big Data
Самой большой проблемой больших данных являются затраты на их обработку. Сюда можно включить как дорогостоящее оборудование, так и расходы на заработную плату квалифицированным специалистам, способным обслуживать огромные массивы информации. Очевидно, что оборудование придется регулярно обновлять, чтобы оно не теряло минимальной работоспособности при увеличении объема данных.
Вторая проблема опять же связана с большим количеством информации, которую необходимо обрабатывать. Если, например, исследование дает не 2-3, а многочисленное количество результатов, очень сложно остаться объективным и выделить из общего потока данных только те, которые окажут реальное влияние на состояние какого-либо явления.
Проблема конфиденциальности Big Data. В связи с тем, что большинство сервисов по обслуживанию клиентов переходят на онлайн-использование данных, очень легко стать очередной мишенью для киберпреступников. Даже простое хранение личной информации без совершения каких-либо интернет-транзакций может быть чревато нежелательными для клиентов облачных хранилищ последствиями.
Проблема потери информации
Меры предосторожности требуют не ограничиваться простым однократным резервированием данных, а делать хотя бы 2-3 резервных копии хранилища. Однако с увеличением объема растут сложности с резервированием – и IT-специалисты пытаются найти оптимальное решение данной проблемы
VVV — признаки больших данных

Чтобы уменьшить размытость определений в сфере Big Data, разработаны признаки, которым они должны соответствовать. Все начинаются с буквы V, поэтому система носит название VVV:
• Volume – объём. Объём информации измерим.
• Velocity – скорость. Объём информации не статичен – он постоянно увеличивается, и инструменты обработки должны это учитывать.
• Variety – многообразие. Информация не обязана иметь один формат. Она может быть неструктурированной, частично или полностью структурированной.
К этим трём принципам, с развитием отрасли, добавляются дополнительные V. Например, veracity – достоверность, value – ценность или viability – жизнеспособность.
Но для понимания достаточно первых трёх: большие данные измеримые, прирастающие и неоднообразные.
Большие данные: с чего начать
Зная, как в общем делится работа между специалистами больших данных, ответить на главный вопрос новичка в мире Big Data «с чего начать», становится гораздо проще. Прежде, чем погружаться в изучение множества мануалов по Apache Hadoop и алгоритмам Machine Learning, необходимо понять, что вас больше привлекает:
- прикладное программирование;
- администрирование;
- проектирование архитектуры информационных потоков и сопровождение;
- анализ данных;
- создание математических моделей и алгоритмов обработки информации.
Кроме того, отметим, что, помимо линейных специалистов (программистов, администраторов, инженеров, архитекторов), знания в области больших данных также необходимы руководителям, чтобы видеть возможности цифровизации своего бизнеса и потенциальную выгоду от его цифровой трансформации. При этом менеджеру совсем не обязательно знать во всех деталях, как, например, работает Apache Kafka. Однако, чтобы не быть «чайником», руководителю крайне полезно ориентироваться в отраслевых сценариях применения средств Big Data (use-cases), понимать способы монетизации больших данных и специфику корпоративной цифровизации, чтобы эффективно расходовать временные, трудовые и материальные ресурсы, а также не ждать от технологий больше, чем они могут дать. Обо всем этом и не только мы рассказываем на обучающем курсе «Аналитика Big Data для менеджеров».
В качестве дополнительной мотивации изучения Big Data, отметим, что профессионалы в этой области больше всех зарабатывают среди ИТ-специалистов. Например, в 2019 году, согласно ежегодному исследованию Stack OverFlow, годовая зарплата аналитиков, инженеров и исследователей данных в США равнялась 60-70 тысяч долларов, т.е. около 350 тысяч рублей в месяц. При этом, поскольку цифровизация стремительно проникает во все сферы деятельности, от промышленности до образования, спрос на специалистов по данным все время растет по всему миру, в т.ч. и в России. Таким образом, большие данные – это очень перспективная и финансово выгодная область ИТ.
Зарплаты ИТ-специалистов в 2019 году по данным Stack OverFlow
Что необходимо знать и уметь аналитику, исследователю, инженеру и администратору больших данных, мы рассмотрим в следующих статьях. Проверить свое знание основ Big Data и Data Science вы можете, пройдя открытый бесплатный интерактивный тест прямо у нас на сайте ответив на 10 простых вопросов по основам больших данных. А освоить практику работы с прикладными инструментами Big Data, Machine Learning и Internet of Things, вам помогут наши курсы обучения и повышения квалификации ИТ-специалистов в лицензированном учебном центре для руководителей, аналитиков, архитекторов, инженеров и исследователей Big Data в Москве.
Смотреть расписание
Записаться на курс
Советы
Соблюдайте логику хранения данных
Нельзя взять способ, которым вы хранили данные в Hadoop, и перенести его, например, в Vertica. Каждая система адаптирована под определенное хранение данных. Это могут быть широкие таблицы, звезда-снежинка, Data Vault, Anchor, третья нормальная форма или гибридная модель. Поэтому адаптируйте архитектуру под продукты и задачи и смотрите, что лучше подходит.
Поделюсь моими историями успеха. Для Oracle и PostgreSQL лучше всего подходит третья нормальная форма, для ClickHouse — широкие таблицы. Vertica и Exasol очень хорошо работают с Data Vault. Ходят слухи, что Vertica круто работает с Anchor. Но мы столкнулись с тем, что с Anchor у каждой сущности появляется еще один интовый ключ. На ClickStream было много значений, и Anchor сильно увеличил объем хранимых данных. Пришлось вместо Anchor воспользоваться Data Vault, который позволяет сократить потребление данных. В Hadoop и Teradata хорошо работали вещи, близкие к третьей нормальной форме.
Выберите Spare Parts: шину данных, UI и ETL Manager
История про UI. Коллеги построили хранилище данных и выбрали UI в виде табло. Все были довольны, пока в компанию не пришел новый CEO. Он сказал: «Ваше табло мне не нравится, я привык к Power BI». Поскольку ребята хорошо построили систему, то переключение с табло на Power BI произошло достаточно быстро. Хорошее хранилище должно позволять подключить любой интерфейс, который является более или менее стандартным. Если аналитик считает, что ему удобно пользоваться табло, значит, нужно подключить табло. Если ему нравится Power BI, значит, нужно подключить его. Для этого есть стандартные протоколы, например, JDBC, есть система, которая поддерживает большинство стандартных UI
Обращайте на это внимание, но это не краеугольный камень. Скорее смотрите, чтобы можно было переключиться.
ETL-менеджер может развиваться динамически. Большинство из нас начинало свой ETL как набор задач в cron. Потом это становится трудно мониторить, и вы переходите на Airflow, Luigi, оркестратор Teradata, на что-то другое. Шина данных позволяет стандартизированно загружать данные в хранилище. Вещь важная, поскольку если вы не заложите ее в начале проектирования системы, то однажды поймете, что новых данных все больше и вам нужен какой-то стандарт для единого протокола загрузки в хранилище. Тогда окажется, что в ядре продукта есть логи, которые никто не хочет переделывать. Вам постоянно придется поддерживать это легаси, которое будет тянуться и тянуться, что весьма неприятно. Лучше ее проектировать сразу, хотя шину данных всегда можно поменять. А поменять хранилище тяжело и дорого.
Не бойтесь совмещать технологии
Вы можете использовать для хранения неструктурированных данных тот же Hadoop или S3 и загружать свои данные в другую базу данных. Если у вас есть специфические интерфейсы, например, для OLAP, то можно использовать дополнительные системы. Есть система Apache Kylin, которая работает с HBase в Hadoop и позволяет вам строить OLAP-кубики для стандартных OLAP-интерфейсов. Выбирайте и комбинируйте.
Есть популярный паттерн, когда на стандартную систему вроде Exasol и Vertica накладывается классическая SMP-система OLTP, в которую складываются подсчитанные данные, а далее из этой системы выдаются ответы. Например, если у вас есть личный кабинет клиента, то под него больше подойдет OLTP-система, в которой он будет смотреть отчеты. Сложные системы тяжелы в поддержке, но это компенсируется их плюсами. Нет системы, идеально решающей все задачи. Если у вас есть несколько популярных задач, будьте готовы, что под них нужно адаптировать разные системы.

